ちなみに

火曜日の空は僕を押しつぶした。

Software Factoryはマーケティング用語なのか

2026年11月6日、Lauren Tan (@poteto) が X にこう書き出す投稿をしました。

hot take: you don't need a software factory, and i don't love the term. it's just marketing

同じ日のうちに Factory の CTO である Eno Reyes が、同意するところは多いが中心の主張には同意しない、と応じました。 2日後には Jeffrey Lee-Chan が The software factory is the next extinct wrapper という記事を出しています。 Software Factory として売られている機能は、コーディングエージェントの進歩によって3〜6ヶ月のうちに大半の人が必要としなくなる、という予測です。
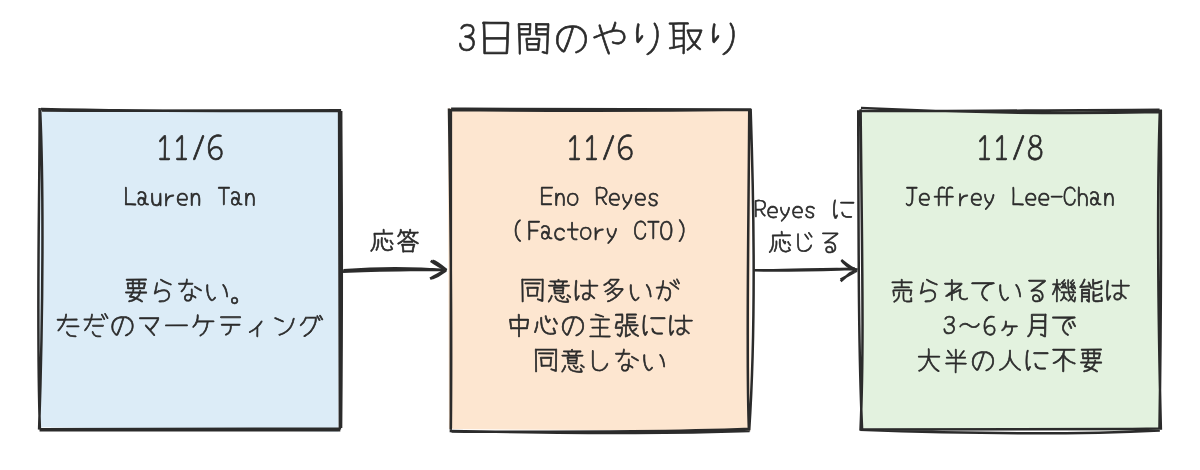
11月6日のTanの投稿、同日のReyesの応答、11月8日のLee-Chanの記事の流れ

Tan、Reyes、Lee-Chan が「Software Factory」で指しているものは一致していません。 以下は2026年11月9日時点の公開資料に基づく整理です。

Software Factory と呼ばれているもの

「Software Factory」と書かれているとき、差しているものは少なくとも三つあります。
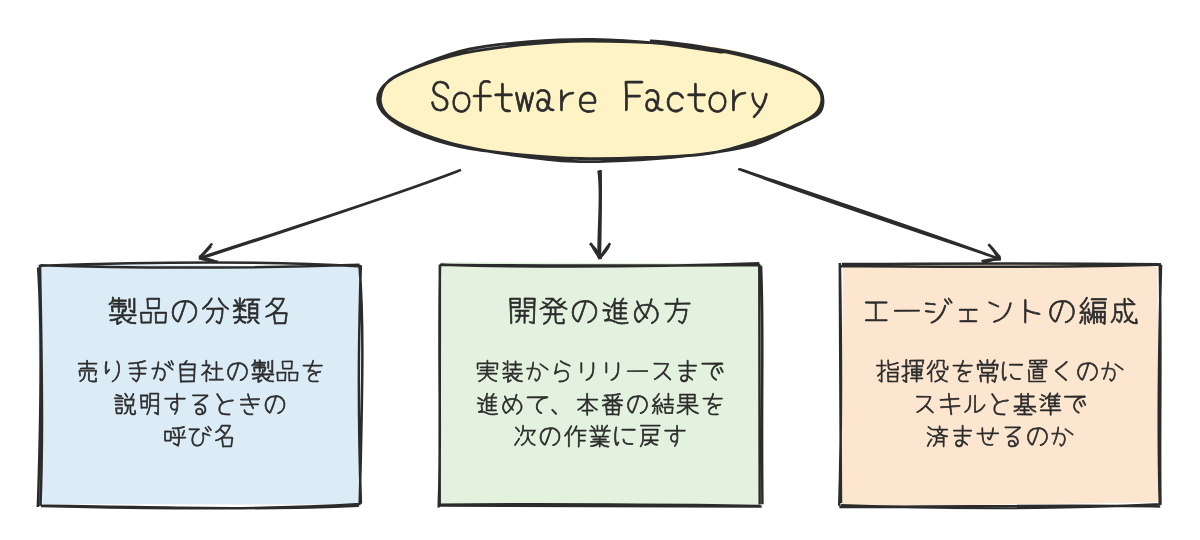
Software Factoryという語が製品の分類名、開発の進め方、エージェントの編成の三つを指すことを示す図

使われ方 指しているもの 例
製品の分類名 売り手が自社の製品を説明するときの呼び名 Warp、Factory、8090、GitLab
開発の進め方 バグ報告や顧客の声を受けて実装からリリースまで進め、本番で起きたことを次の作業に戻す一連の仕組み Factory の定義、Prinevo の整理
エージェントの編成 指揮役のエージェントや複数の工程を常に置くのか、スキルと基準だけで済ませるのか Warp のドキュメント、Lee-Chan の記事

Factory は会社の名前でもあります。 同社の解説も 「software factory」は概念の名前で、Factory はその一実装の会社と製品だと分けて書いています。

The Beat の整理によると、「Software Factory」という語は GitLab、Harness、Opsera、Uber などが使っていて、米国防総省は何年も前から使っています。 OpenAI は自社の製品を「Codex as a platform」と呼び、この語を使っていません。 2026年11月2日時点で、この語は共有されたマーケティング用語になっている、というのが The Beat の見立てです。 一方で、使用量の料金を API 価格への上乗せ率として明示しているのは、Warp と SuperPlane という小さな売り手だけだそうです。

批判の対象

2026年9月から11月にかけて、次のような批判が出ています。

論者 主張 根拠
Lauren Tan Software Factory は不要で、言葉自体がマーケティングにすぎない。必要なのは良いソフトウェア工学と、トークンを正しい場所に使うこと。決定論的な処理を増やすほど良く、トークンの消費も減る 短い投稿のみで、数値や事例は示していない
Jeffrey Lee-Chan モデルが強くなるほど、モデルの外側に足す仕組みは要らなくなる。製品が売りにしているエージェントの調整は3〜6ヶ月で大半の人に不要になり、残るのは自社のスキルと基準だ 自身の WorldAI 開発で、約1週間、1日約100件の PR をマージした(以前は約20件)という自己報告
Auditless Research 本来は開発のループが自動で閉じる仕組みを指すはずだが、いま売られている製品はそうなっていない。多くの組織の制約はレビューの人手なのに、ベンダーへの依存が生まれるプラットフォームを先に売っている Factory の説明の引用と、クラウド移行期のベンダー依存との比較
Irfan Suleman 1980年代の日本と米国防の Software Factory は、数えやすい成果を追って行き詰まった。2026年のものが違うのはエージェントそのものより、社内の知識を機械が読める形に整える点だ 過去の事例の記述と、Uber が公表した数字
Pekka Enberg エージェントをクラウドの sandbox で自律的に動かす流れは、自分の働き方と逆だ。隔離は OS に任せ、ソースコードは人が読む 自身の開発経験。Software Factory の製品への反論として書かれたものではない

Tan が問題にしているのは用語そのものです。 Lee-Chan は製品の寿命、Auditless は売り方、Suleman は測るもの、Enberg は働き方。
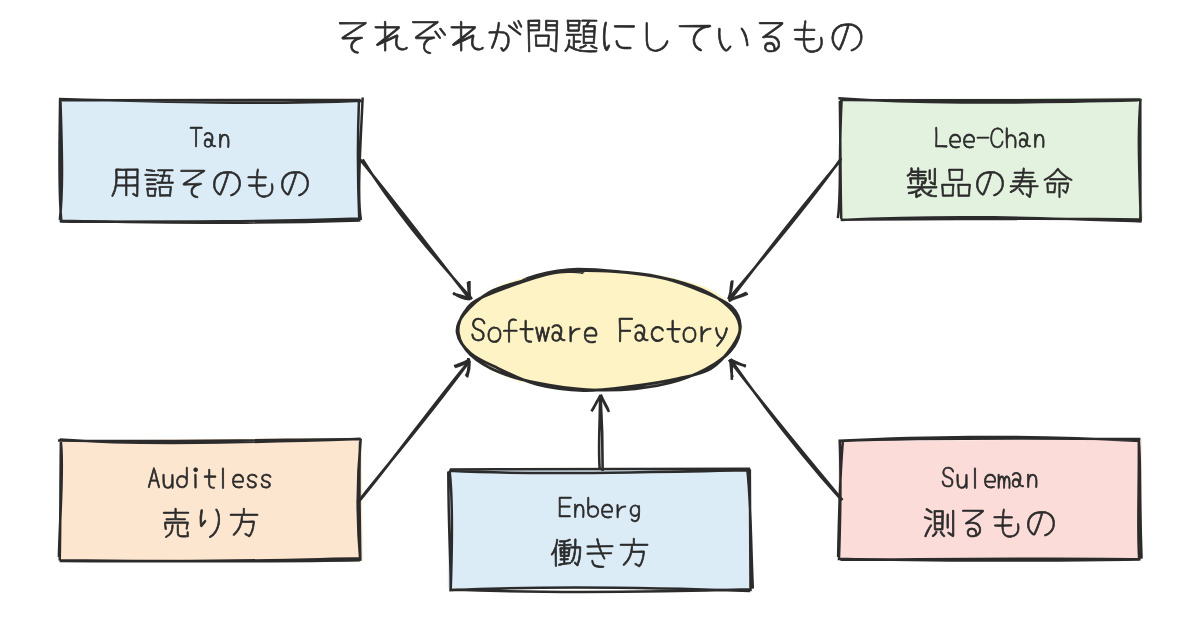
5人の論者がそれぞれ問題にしているものを示す図

Lee-Chan の方針は「front-load alignment, back-load verification」(先に認識を揃え、検証は後ろに寄せる)です。 残すと書いているのは権限の境界とテスト、実際のユーザージャーニー、証拠、マージとリリースの権限です。 公開している pr-lifecycle スキル(2026年11月9日時点の main)にも、独立レビュー、SHA に紐づく証拠、完了の認定とマージ権限の分離が書かれています。

製品を作っている側の説明

Reyes によると、ほとんどの人は Software Factory と呼べるシステムを実際には持っていません。 AI で出荷を楽にしただけの状態を見て、Software Factory という種類のシステムがそもそも存在しないと考えている、という見立てです。

Software Factory とは、すべての作業が通るプロセスを標準化することで、人が書いても AI が書いても同じ検証を通す、と Reyes は書いています。 Factory の場合は Slack のスレッドや Sentry のアラートなどのシグナルから始まります。 最初の検証は Droid(同社のエージェント)のレビューとセキュリティレビューです。 続いて「a risk judge that can't see who wrote it」(誰が書いたか見えないリスク判定)、CI、ライブプレビューでの QA を通します。 本番で壊れたら原因の PR まで辿ります。
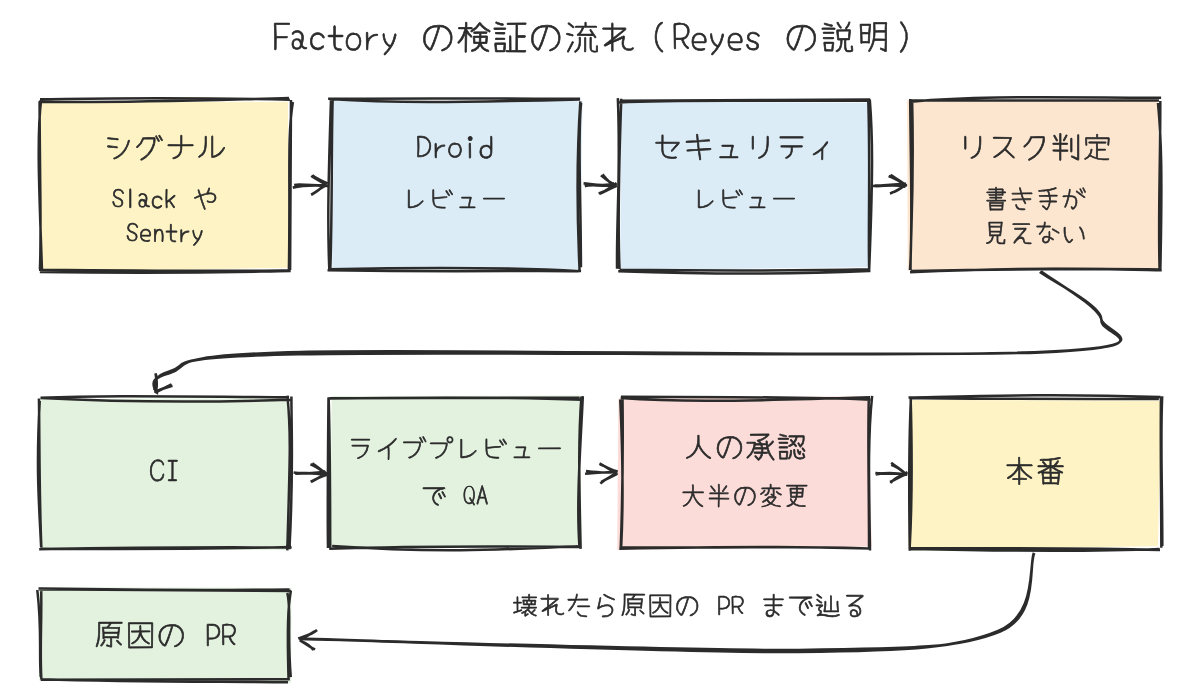
シグナルから本番まで進み、壊れたら原因のPRまで辿るFactoryの検証の流れ

目標は「regret-free merge rate」(後悔しないマージの割合)です。 同時に「Most of our changes still get a human stamp.」(大半の変更にはまだ人の承認が入る)とも書いています。

Factory と Warp も、公式の説明では無条件の自律を謳っていません。

Factory Warp
定義 バグ報告や顧客の声を受けて、計画、実装、テスト、レビュー、リリース、監視まで回し続けるループ。モデルを選べること、組織が自分で管理できること、学習し続けることを条件にする foreman(指揮役のエージェント)が品質方針を満たす最短の手順を選ぶ。不要な工程は飛ばし、やり直しが必要なら前の工程に戻す
人の関与 自律は時間をかけて段階的に進めるもので、最初から人手なしで動いている組織はないとする。小さなタスクは通常のセッションで、複数の機能にまたがる作業は Mission で扱う 仕様の承認と、不明点の確認で人を待つ。マージするかどうかはチームが決める
計測と改善 開発の全工程を計測し、障害を原因の PR まで辿れるようにする 設定はファイルで管理して PR でレビューする。自動で出た改善案も PR として届き、人が確認するまで採用されない
数字の扱い 顧客が報告した数字は特定の作業での結果で、一般的な生産性の向上を示すものではないと明記している 自社のタスクの約30%を Software Factory で自動化しているという自己報告

Reyes の説明する標準化については、Lee-Chan が、基準はスキルとガードレールに書けるので Software Factory を製品として買わなくてもよい、と応じています。

擁護でも全否定でもない人たち

Sohit Kumar の Software Factory vs Coding Agent は、コーディングエージェントとその周りのデリバリーの仕組みを分けます。 この仕組みは共有の文脈、担当者、ハンドオフ、検証の証拠からなります。 自作か製品かは問わず、「Start with the bottleneck you can observe」(観測できるボトルネックから始める)と勧めています。 Prinevo というベンダーの記事です。

Addy Osmani の Your coding agents made you a manager は Software Factory という語を弁護していません。 書いてあるのは、合否がはっきり出る自己検証と証拠、目的、制約、対象外、完了条件を書いた指示、修正を重ねても直らなければセッションを捨てること。 プロンプトやスキルは依頼で、強制は hooks や deny ルールが担うという区別と、並列の数は検証が追いつく速さまでという話もあります。

Steve Yegge は「I have given up on building reusable harnesses」(再利用できるハーネスはあきらめた)と書いています。 一方で、ゲーム Wyvern のために自前の Software Factory である Wheelhouse を動かしています。 Wheelhouse は計画、実装、レビューで役割とモデルを分けていて、憲法と450の法的文書を持ち、規模は約60万行(ほとんど bash)です。 Wyvern の作業の20〜25%は Wheelhouse 自体の保守だそうです(いずれも Yegge 自身の報告)。

Lee-Chan はこれを、再利用できる製品より案件に固有の判断に価値がある例として引いています。

揃っているところと割れているところ

Reyes、Lee-Chan、Osmani、Warp と Factory の公式は、書き方は違っても、検証と証拠と完了の条件を前提にしています。 人の関与も残っていて、Factory では大半の変更に人の承認が入り、Warp の既定ではマージをチームが決め、Lee-Chan はマージの権限を残します。

割れているのは次の五つです。

争点 批判する側 反対の立場
用語そのもの 単なるマーケティング用語だ(Tan、The Beat) 実際に作った人が少ないので、存在しないと思われている(Reyes)
汎用の製品は残るか 3〜6ヶ月で大半の人に不要になる(Lee-Chan) 全工程の計測や、品質方針に沿った手順の選択を製品が担う(Warp、Factory)
何を約束しているか 経営層には「infinite loop with 0 people」(人手ゼロで回り続けるループ)を売りながら、実際の mission は有限だ(Auditless) 自律は段階的に進めるもので、最初から人手なしで動いている組織はない(Factory)
何を測るか PR 数のように数えやすいものを追うと失敗する(Suleman) 後悔しないマージの割合を目標にし、本番の障害を原因の PR まで辿る(Reyes)
どこに作るか 自社のスキルと基準に書けば足りる(Lee-Chan) 案件専用のシステムとして作る(Yegge)、自作でも製品でもよいが担当者と検証の証拠は要る(Prinevo)

出回っている数字のほとんどは自己報告です。 Lee-Chan の 100 PR/日、Warp の約30%、Suleman が引く Uber の数字。 The Beat が留保つきで紹介している CampusIQ の PR あたり約29ドルも、トークン代だけで集計期間の記載がありません。 どれも欠陥率を示す数字ではありません。

Lee-Chan の予測どおりなら、2027年の春には大半の人が Software Factory の製品を必要としなくなっているはずです。 そのころこの語がどう使われているのか、気になりますね。

参考文献

Uber と CampusIQ の数字、歴史の話は Suleman と The Beat の記事経由で、元の文献の中身までは確かめていません。

形式手法に入門したけど難しくて何もわからない

形式手法を勉強し始めたので、道具を触る前に考え方だけ自分用にまとめておきます。

テストとの違い

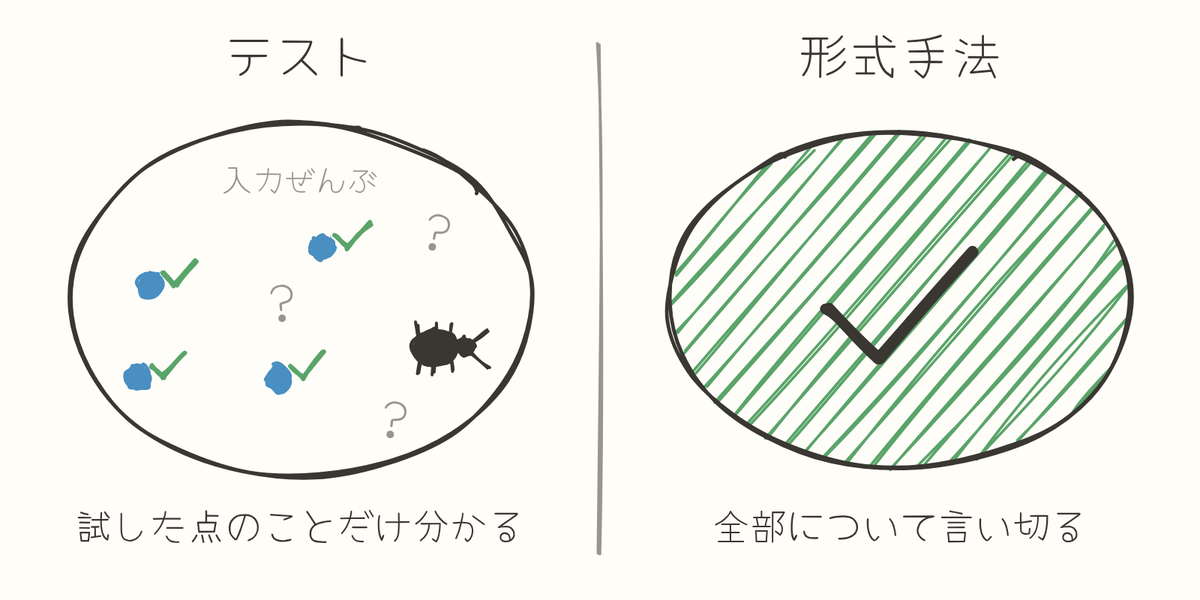
テストで分かるのは、試した入力で正しく動いたことだけです。 ソート関数を [3, 1, 2] や [] で試して通っても、同じ値が並ぶ [2, 2, 1] やとても長い配列のことは何も言えない。

形式手法は、プログラムや設計の性質を数学の言葉で書いて「どんな入力でも成り立つ」と言い切るための方法の総称です。 ソート関数なら「どんな配列を渡しても、返る配列は昇順に並び、要素は入力と同じものが同じ数だけある」を、すべての配列について確かめます。

テストは試した点を調べて、形式手法は全体を調べる。 そのぶん、性質を曖昧さなく書く手間と、全体を調べきるための計算や証明の手間がかかります。

テストは試した点だけが分かり、形式手法は入力全体について言い切るイラスト

仕様と実装

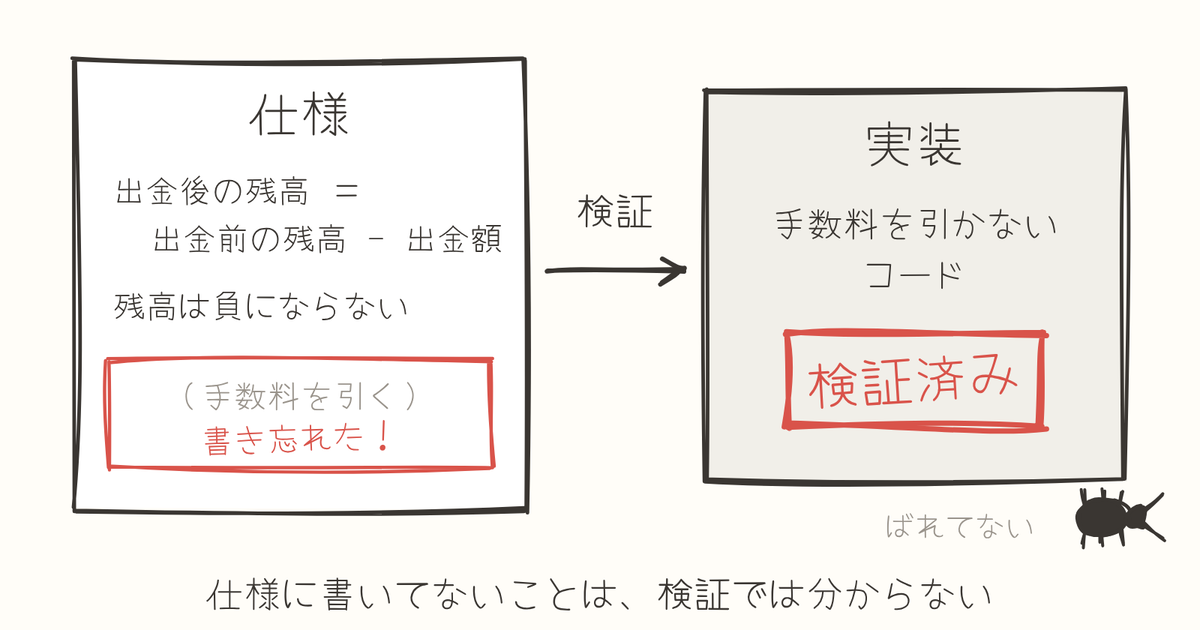
仕様は何が正しいかを曖昧さなく論理式で書いたもの、実装は実際に動くコードです。 検証が確かめるのは「実装が仕様を満たすか」だけ。

銀行口座の出金処理なら、仕様は「出金後の残高 = 出金前の残高 − 出金額」と「残高は負にならない」のように書けます。 検証が通れば、実装はこの2つを必ず守ると言えます。

ただ、仕様に「手数料を引く」を書き忘れていたら、手数料を引かないコードも検証を通ります。 検証済みは「仕様どおり」という意味で、「バグがない」という意味じゃない。 何を仕様として書いたかは、結局人が読んで確かめるしかない。

仕様に手数料を書き忘れると、手数料を引かないコードも検証済みになるイラスト

事前条件と事後条件

処理を始める前に成り立っているべき条件が事前条件、処理が終わった後に成り立つと約束する条件が事後条件です。

この組を書く代表的な記法がホーア論理の三つ組 {P} C {Q} で、「P が成り立つ状態で C を実行し、C が終われば、Q が成り立つ」と読みます。 「x が 5 なら、1 足した後は 6」と「出金額が残高以下なら、出金後も残高は負にならない」はこう書けます。

{ x = 5 }              x := x + 1                    { x = 6 }
{ amount ≤ balance }   balance := balance - amount   { balance ≥ 0 }

amount ≤ balance がなければ事後条件は守れないので、事前条件は呼び出す側が守るべき約束でもあります。

ソート関数なら、事前条件はなし(どんな配列でもよい)、事後条件は「出力は昇順」かつ「出力は入力の並べ替え」。 「出力は昇順」だけを書くと、常に空配列を返す関数も合格してしまう(最悪)。

不変条件

不変条件は、ある範囲の中でいつ見ても成り立っている性質で、2種類あります。

ループ不変条件は、ループの各回の始めに必ず成り立つ性質です。 配列 a の合計を求めるループ(i を 0 から n まで進め、s に足していく)なら、「各回の始めで s = a[0] + … + a[i-1]」がそれ。 ループが終わったとき i = n なので、そこから s が全体の合計だと導けます。

システム不変条件は、システムがどの状態にあっても成り立つ性質です。 銀行なら「どの口座の残高も負にならない」「全口座の残高の合計は、入金の合計から出金の合計を引いたものに等しい」など。

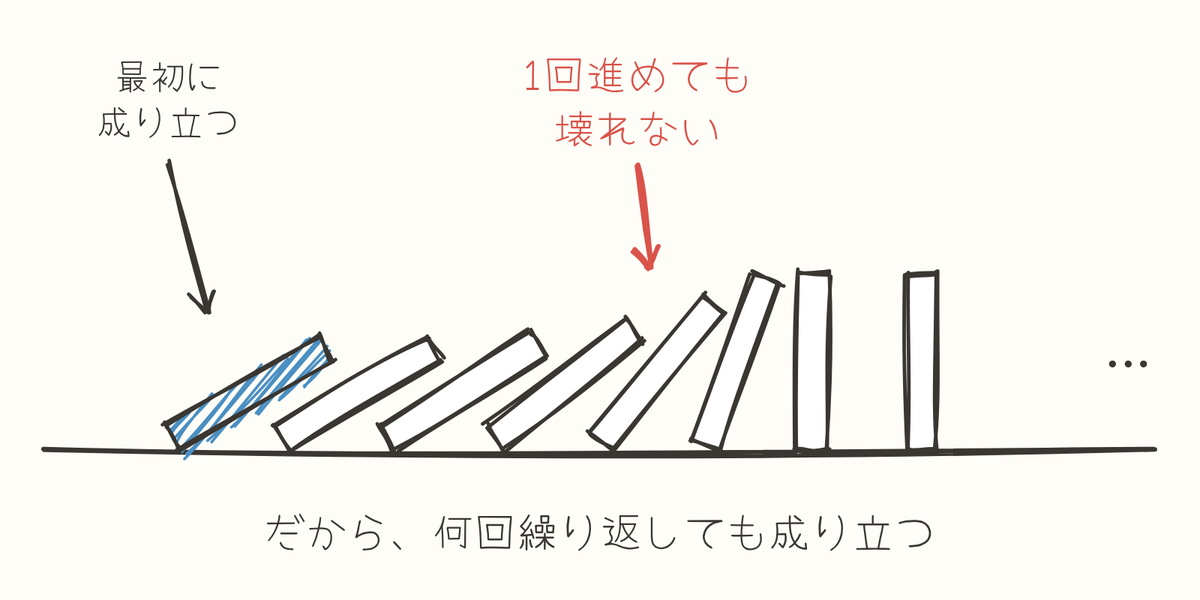
証明の中心は、多くの場合この不変条件を見つけることです。 ループや状態遷移は何回繰り返されるか分からないけど、1回進めても壊れない性質が見つかれば、何回繰り返しても成り立つと言える(数学的帰納法と同じ形)。

最初に成り立ち、1回進めても壊れなければ何回繰り返しても成り立つことをドミノで表したイラスト

ただ、守りたい性質そのままだと1回進めただけで壊れることがあって、もう少し強い性質を探す必要があるらしい。 ここに人の工夫が要ります。

安全性と活性

信号機の交差点で考えます。

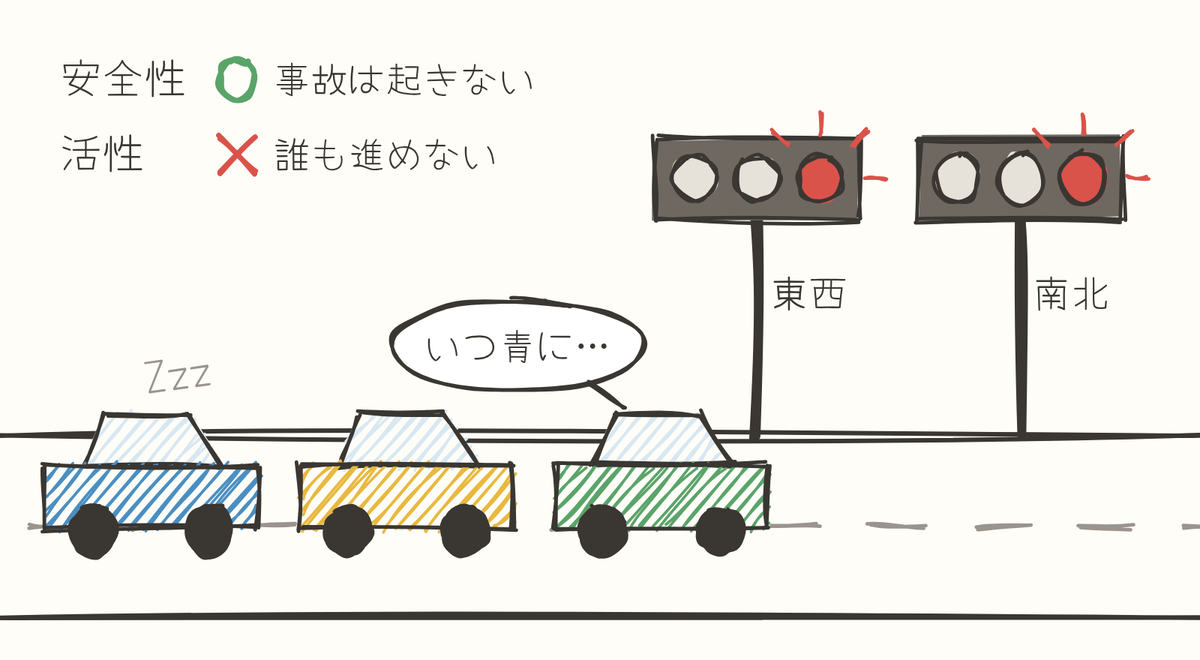
安全性は「悪いことは決して起きない」性質で、「東西と南北の信号が同時に青になることはない」のようなものです。 違反するなら、違反に至る有限の手順(反例)を示せます。

活性は「良いことはいつか必ず起きる」性質で、「赤で待っている車線は、いつか必ず青になる」のようなものです。 違反は「ずっと青にならない」という無限の実行なので、確かめ方が安全性より難しくなります。

ずっと全部赤の信号機は、事故は起きないけど誰も勧めません。 安全性だけだと何もしないシステムが合格してしまうので、両方書きます。

全部赤の信号機の前で車が待ち続け、安全性は満たすが活性は満たさないイラスト

確かめ方

大きく3種類あります。

モデル検査

システムを状態と状態の移り変わりで表し、到達できる状態を全部たどって性質を調べます。 信号機なら、色の組み合わせと切り替わりの規則を書いて、到達できるすべての組み合わせで「同時に青」がないかを見る。

全自動で、性質が破れれば反例を出してくれます。 ただ、変数や並行に動く主体が増えると状態の数がかけ算で増える(状態爆発)ので、口座は2つ、利用者は3人のように小さく絞って調べます。 代表例は TLA+ の検査器 TLC です。

Quint も仕様を書いて調べる言語で、モデルと性質を書くと TLC や Apalache でモデル検査できます(quint verify)。 ランダムに動かすシミュレータ(quint run)も付いていて、こちらは違反を見逃すことがあるけど、見つけたら反例を出してくれます。 ソフトウェアのモデリング言語だと Alloy もあります。

ループの回数や手順の長さに上限を決めて、その範囲を全部調べる有界モデル検査(Biere ら、1999年)もあります。 C や C++ 向けの CBMC や Rust 向けの Kani がこれで、上限を超える振る舞いは保証しません。

SMT ソルバー

「性質を破る入力は存在するか」を、制約を満たす値を探す問題として解きます。 出金処理なら「amount ≤ balance かつ balance - amount < 0 を満たす整数はあるか」と聞く。

「ない(unsat)」と返れば性質はどんな整数でも成り立ち、「ある(sat)」と返れば具体的な値が反例として返ります。 多くは自動で答えが出るのだけれど、式の種類によっては「分からない(unknown)」が返ります。

代表例は Z3 と cvc5 です。 プログラムの検証器の内部でもよく使われていて、検証機能付きの言語 Dafny や Rust 向けの Verus は Z3 を使います。 CBMC は SAT ソルバー(SMT の土台にある、真偽値だけを扱うソルバー)を基本に使います。

定理証明

性質の証明は人(最近は LLM も)が一歩ずつ書きます。 その一歩一歩の正しさを、証明チェッカーが機会的に確かめます。 ソート関数なら「出力は昇順」を、配列の長さについての帰納法で証明していく。

有限に絞る必要がなく、無限の入力や任意の大きさのシステムについて言い切れます。 その代わり証明の道筋は人が与えることになるので、手間はとても大きい。 代表例は Rocq(旧 Coq)、Lean、Isabelle です。

既存のファズテスト(ランダムな入力を流すテスト)を仕様にして、Claude が 123 のライブラリで「64MB 未満のどんな入力でもテストが落ちない」ことを Rocq で証明した報告も出ています。

3つの比較

手法 自動化の度合い 言える強さ 手間 代表ツール
モデル検査 全自動 絞った有限の範囲で全部 小(モデルを書く) TLC、Quint、CBMC、Kani(有界)
SMT ソルバー ほぼ自動(unknown あり) 解ければ全入力で成立 小〜中(制約に落とす) Z3、cvc5
定理証明 人が道筋を書く 無限の範囲でも言い切れる 大 Rocq、Lean、Isabelle

なぜ全自動にならないのか

どんなプログラムについても性質が成り立つかを必ず正しく判定する道具があればいいのだけれど、それは作れないことが証明されています。

停止性問題は、任意のプログラムがある入力で止まるかどうかを必ず正しく判定するプログラムは存在しない、という定理です(Turing の1936年の論文が元になっています)。 ライスの定理は、「0 を返すことがあるか」「配列の外を読むことがあるか」のような振る舞いの性質も、自明でないものは一般には判定できないと言っています(Rice、1953年)。

そのため、どの手法もどこかで諦めています。

手法 諦めたもの 残るもの
モデル検査 調べる範囲を有限に絞る 範囲の中は全自動で答えが出る(外は保証しない)
SMT ソルバー 「分からない」と答えることを許す 答えが出たときは正しい
定理証明 証明を自動で見つけること チェッカーは与えられた証明が正しいかを機械的に判定できる

前提になる数学

分野 内容 例
命題論理 真か偽かが決まる文を「かつ(∧)」「または(∨)」「でない(¬)」「ならば(→)」でつなぐ 東西が青 → 南北は赤
述語論理 変数を含む条件と「すべての(∀)」「ある(∃)」を加える ∀口座 a. 残高(a) ≥ 0
集合と関数 状態の範囲や対応を書く 信号の色の集合 {赤, 黄, 青}

反例探しは「∃口座 a. 残高(a) < 0」が成り立つかを調べることに当たります。 ソートの「入力の並べ替え」は、「各値の出現回数を数える関数が、入力と出力で等しい」と書ける。

大学初年度の論理と集合の範囲で足りる気がします。 読み書きできれば十分で、難しい定理を覚える必要はなさそう。

そのほかの用語

用語 意味
健全性(soundness) 道具が「成り立つ」と言ったら本当に成り立つこと。健全でない検証器は間違った証明を通してしまう
完全性(completeness) 成り立つ性質なら道具が必ず「成り立つ」と言えること。誤った警告や「分からない」がない
証明チェッカー 書かれた証明の一歩一歩が論理的に正しいかを機械的に確かめるプログラム。信頼すべき部分を小さく保てる
形式モデル CPU、OS、プロトコルなど現実のシステムを数学の言葉で書いたもの。モデルと現実のずれは検証の外に残る

実用的な検証器は健全性を優先して、完全性はあきらめることが多いらしい。 バグ検出ツールの文脈では「報告したバグは本物」を健全性と呼ぶこともあって、分野で向きが逆になるのはちょっとややこしい。

参考文献

本文の出典も含めて、どれも概要をさらっただけで、中身はちゃんと読めていません。

元になった論文

教材と解説

Kindle Oasis の本がぜんぶ「Item Not Available」になった

Kindle Oasis で本を開こうとしたら「Item Not Available」と出て開けなかった。別の本も、その次の本も同じで、ライブラリにある本がぜんぶ開けなない。

Grok bot に相談したら、Reddit などから似た症状の報告を集めてきてくれた。端末の空き容量が極端に少ないと起きる、いわゆる「スペースバグ」というのがあるらしい。

設定 → 端末オプション → 端末情報で見てみると、たしかに空き容量がほとんど残っていない。症状も似ているので、これではということで Grok bot が挙げた手順を試すことにした。

まず機内モードにして、電源ボタンを 40 秒ほど長押しして強制再起動する。

そのあと Mac に USB でつなぎ、ドライブとして認識されるまで数分待ってから、安全に取り外して再起動する。USB でつなぐだけで何が変わるのかはよく分からない。

最後は Wi-Fi に戻して同期し、日時が合っているかも確認した。

これで本が開けるようになりました。

Grok bot からは、これでも直らなければ手動でアップデートするか、登録解除して再登録する、最悪は工場出荷リセットという案も出ていた。リセットすると端末内の本は消えるので、そこまで行かずに済んでよかった。

端末内ストレージの一覧情報(インデックス)が壊れていたんじゃないか、というのが Grok bot の見立て。ちゃんとした原因は分かっていない。

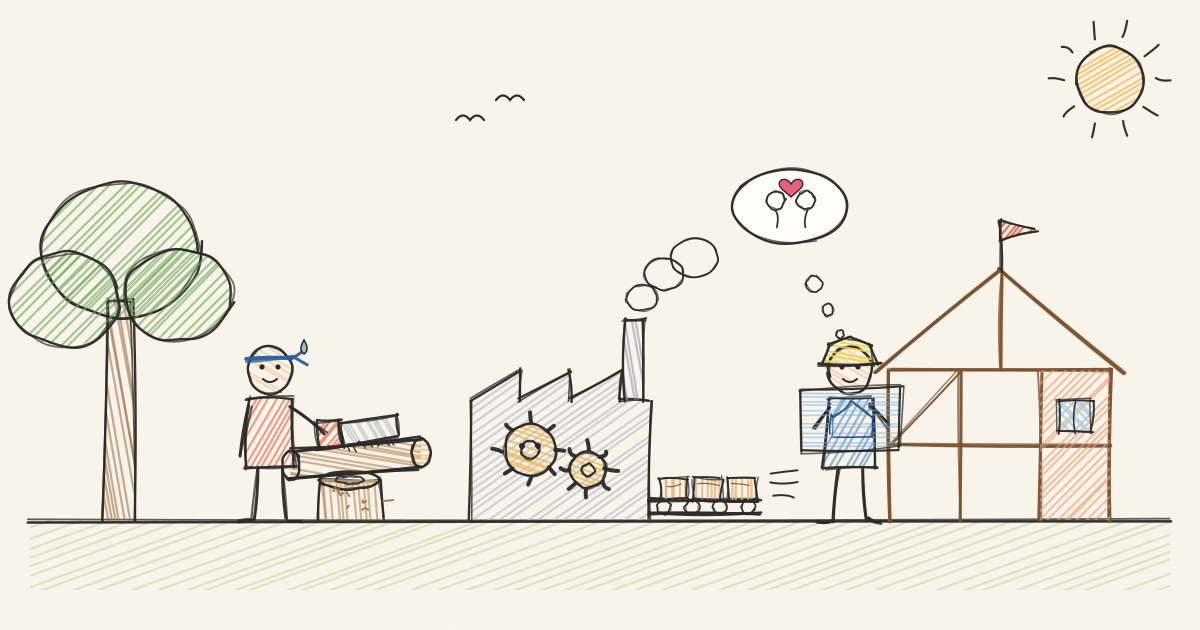
木を切る人と家を建てる人

任天堂の宮本茂さんが、文化勲章の受章が発表される前日の記者会見で生成 AI について聞かれ、「作る」ことと「作業する」ことを分けて考えている、と話していた。 何かを作るときはまず大きな構成を作る。そこから先の、空いている穴を埋めたりきれいに仕上げたりするのが「作業」だという。

news.denfaminicogamer.jp

ワープロやコンピューターがレタリングのような技術的な部分を引き受けたことで、レイアウトのセンスのような個人のデザイン能力は表に出てきた。 生成 AI で起きているのもそういうことだ、とも言っていた。

面白いのはその続きで、宮本さんは「作業って楽しいんです」と言う。 作業をしていると作っている満足感があって、怖いのはその作業に満足して「けっこういいものができた」と勘違いしている自分だ、と。

ここしばらくもやもや考えていたことに、ちょうど名前をもらえた気がした。

木を切る人と家を建てる人

木を切る人は、コードを書くこと自体が目的の人。 きれいな設計や、問題を解いているときの没入、手に馴染んだ道具で精度よく仕上げる職人性に喜びがある。

家を建てる人は、プロダクトを作ってユーザーに届けることが目的の人。 コードは家を建てるための木材加工で、手段にすぎない。

一人の中に両方いることがほとんどで、どっちに比重があるかの違いだと思う。(僕もコードを書くのはふつうに好き) 宮本さんの言葉に寄せると、木を切るのが「作業」、どんな家を建てるかを決めるのが「作る」にあたる。

AI で急に安くなったのは、木を切るコストのほうです。 手斧がチェーンソーになり、さらにプレカット工場になったくらいの変化で、寸法を伝えれば加工済みの部材が届く。

一方で、どんな家を誰のために建てるかという問いは変わらない。 施主と話して要件を決め、間取りを設計し、安全基準を満たしているかを検査する仕事は、部材の加工が速くなっても消えない。 部材が大量に届くぶん、検査の比重はむしろ上がる木がする。

先日、友人たちと AI レビューの話をしたときも、AI レビューだけで回すのはまだ怖いという点では全員一致していた。 落としどころは、高リスクな変更を機械的に見つけてそこだけ人が見る、というあたり。 「SWE はもともと不確実性との戦いだった」と言っていた人がいて、木を切る部分が機械化されてもそこは残るんだろうなと思う。

同じ変化が逆の意味になる

木を切る人にとって、この変化は喪失として届きやすい。 手を動かして解く時間が減って、自分が何者なのかが揺らぐ。

家を建てる人にとっては、加工待ちが消えて設計や対話に時間を使える解放として届く。 同じ道具の変化が、目的をどこに置くかで逆の意味になる。

Baldur Bjarnason の「Software developers are not okay」 は、前者の側から書かれた文章だと思う。 開発者の燃え尽きや離職の広がりを、人員を減らして働き手の交渉力を削ぎたい経営側のインセンティブで説明している。 主流のソフトウェア開発はこの先も良くならないだろうから、業界の外の将来も考えたほうがいい、と結んでいる。

彼も木工の比喩を使っている。 電動工具は作り手の思い入れを減らさなかった。 けれど LLM は自動化というより委任に近く、作り手を成果物から切り離してしまう、という。

その切り離しの感覚は、木を切ることに目的を置いた人の視点としては正確だと思う。 ただ、それをソフトウェア開発者全体の結論に広げているところには同意できない。 委任で切り離されるのは木からであって、家からではない。部材の加工を工場に頼んでも、家を建てた実感はなくならないはずです。

かといって、木を切る人を「目的を取り違えた人」と読むのも違う。 職人性への愛着はこれまで品質を支えてきたし、喪失感は本物だ。

宮本さんの「作業って楽しいんです」は、その裏返しなんだと思う。 そして家を建てる側も、作業の満足感を「作った」実感と取り違えうる。AI が出してきた大量の部材を眺めて家が建った気になるのは、たぶん僕のほうだ。

これからの仕事

家を建てる側の仕事は、たぶんこんな形に分かれていく。

  • 棟梁と設計者。何を誰のために作るかを決め、AI に渡す意図をはっきりさせる。いくつかの案からどれを採るかを選ぶ
  • 検査官。リスクの高い変更を見分けて、人が見るべき箇所を決める
  • 道具を作る人。木を切る作業を機械化する側で、ハーネスや lint、リスク判定の仕組みを作る
  • 職人。手で木を切ることが価値を持ち続ける領域で、趣味のプログラミングのほか、物理的な制約や規制で決定的な作りが求められるところ

棟梁と設計者の仕事は、宮本さんの言う「作る」そのものだ。 検査官は、友人たちと話した落としどころ(高リスクな変更だけを人が見る)にそのままあたる。

道具を作る層は、安定した場所ではない。 Anthropic は、意図分類器や固定の多段パイプライン、多数のサブエージェントといった構造の多くが、モデルにはもう要らない仕事をしていた事例を報告している。道具そのものも、モデルに吸収されていく。

職人の領域については、友人の一人が「決定的に作れるものは決定的に作りたい。HSM 周りのように、良いモデルだけでは解決できないところもある」と言っていた。

比喩がこぼすもの

では、家を建てる側に回れば安泰かというと、そうでもない。 部材の加工が速くなれば、一件あたりに必要な人数も減る。 Baldur の議論の中心にある雇用の問題に、この比喩は答えていない。

境界もきれいには引けない。 アーキテクチャやデータモデルの設計は、木を切ることと家を設計することの両方に属している。

いちばん引っかかっているのは育成です。 設計の目は、木を切る経験で育っていた面がある。木の癖を知らない設計者が、プレカット部材の不具合を見抜けるのかは分からない。

手で飛ぶ時間

判断力を育てていた手作業を自動化が取り上げる、ということはほかの分野でも起きてきた。 木を切ったことのない人の育て方には、そこに糸口がありそうだと思って少し調べた。

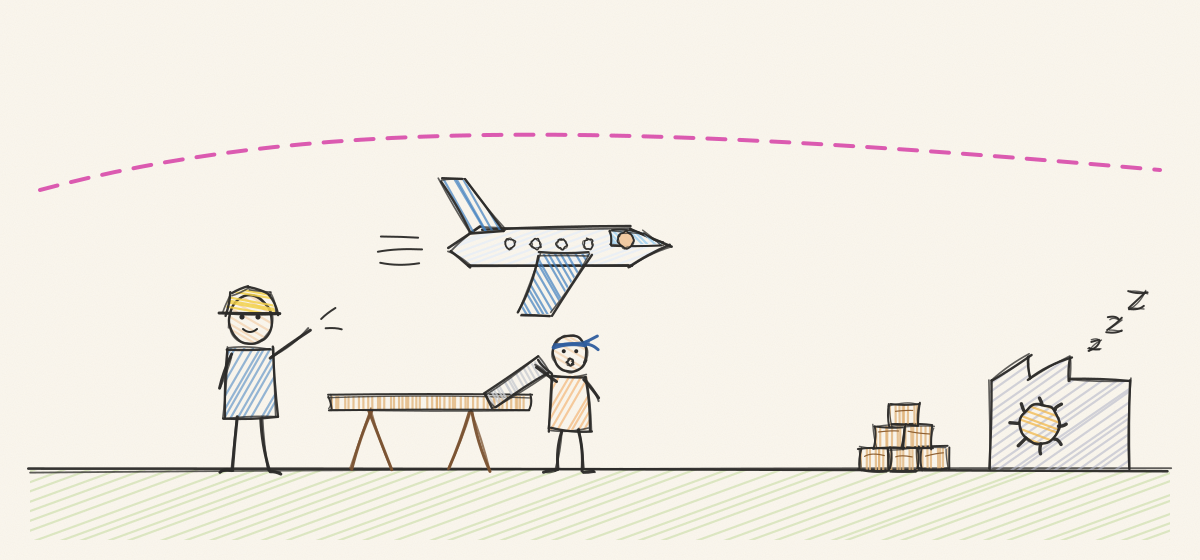
航空では、American Airlines の Warren Vanderburgh 機長が 1997 年の訓練講義で、操縦室で一番多い質問は「What's it doing now?」だと言った。 そして、画面のマゼンタ色の経路線と自動化に頼りきった操縦士を「Children of the Magenta」と呼んだ。 勧めたのは自動化を捨てることではなく、状況に応じて自動化のレベルを下げることと、条件が許すときは手で飛んで腕を保つことだった(AOPA の解説)。

2013 年には FAA が SAFO 13002「Manual Flight Operations」 を出して、手で飛ぶ機会を運航方針と訓練へ組み込むよう、航空会社へ求めている。 現場の機長が言っていたことを、16 年後には規制当局も文書で求めたことになる。

外科では Matt Beane の研究がある。 ロボット手術になって執刀医が一人で手術できるようになり、研修医の実技時間は開腹手術に比べて 10〜20 分の 1 になった。それでも腕を上げた研修医は、シミュレーターや手術動画を使った反復を、承認された訓練の外で自主的にこなしていた。 Beane はこれを shadow learning と呼んでいる(UCSB の紹介記事)。

建築では、Sherry Turkle の『Simulation and Its Discontents』が、鉛筆で設計しなくなった建築学生を描いている。 若い設計者たちが、師匠世代の持つ建物や身体についての暗黙知を必死に取り込もうとしている、とも書いている。 分野としてどう応じたかまでは確かめきれていない。

プログラミング自体にも前例がある。 John Backus の回想によると、1954 年当時のプログラマーは効率のよいプログラミングは自動化できないと確信していた。 FORTRAN チームは、手書きに近い効率のコードを出せなければ受け入れられないと考え、言語設計よりコンパイラの出力効率に力を注いだ。道具の側が品質を示して信頼が移った例なので、ほかとは少し性格が違う。

どの分野でも、答えは昔の手作業に全部戻ることではなかった。 判断力を育てる作業を選んで、訓練として意図的に残す方向だった。

ソフトウェアに当てはめると、このあたりだと思う。

  • 場面を決めて、コードを手で書いたり読んだりする時間をとる
  • AI の出力を検査する訓練を明示的にやる。どこが危ないか、なぜその実装なのかを自分で説明できるか確かめる
  • 障害対応やデバッグのドリルを、シミュレーター訓練のつもりで定期的に回す
  • AI を使う開発の流れを、若手を仕事の輪から外さない形に組む

最後のは、Beane が著書『The Skill Code』で言っていることでもある。

僕の軸足

コードの書き方は、AI でこれからも変わっていくと思う。 ただ、プロダクトを作ってユーザーに届けるという目的のほうは変わっていない。

僕は家を建てる側に軸足を置いて、木を切る作業は道具に任せる範囲を広げていくつもりです。 (とはいえ手で木を切るのも楽しいので、そこは趣味として残しておきたい)

気をつけたいのは、宮本さんの言う勘違いのほうだ。 部材が速く大量に届くと、それだけで何かを作った気になりやすい。届いた部材でどんな家が建ったのか、住む人にとっていい家なのかを見る目は、道具に任せられない。

その目をどこで養うのかは、まだ分からない。 木を切る経験の少ない人がどこで検査の目を身につけるのか。僕自身も、木を切る時間が減ったあとで今の目を保てるのか。 自動操縦を切って手で飛ぶ時間を、自分たちのチームではどう作ればいいのか考えている。

通販で買ったコーヒー豆のお店マップを作った

コーヒー豆はほとんどオンラインで買っています。 ただ、買うのはいつも知っているお店ばかりで、同じところをぐるぐる回っていた。

それもちょっともったいない気がして、2024年の秋くらいから全国の焙煎所を調べて、まだ買ったことのないお店から取り寄せる活動を始めました。都道府県をひとつずつ埋めていく感じで、いまも続けています。

買ったお店がだいぶ増えてきたので、地図にまとめたサイトを作りました。

roaster-map.nishimu.land

載せているのは通販で買ったお店だけで、店頭やカフェで買った分は入れていません。 いまのところ64軒、43都道府県で、通販での購入は117回。残りは富山、福井、鹿児島、沖縄。

ピンを押すと、そのお店で買った豆と感想が出ます。何度も買っているお店には回数が付くので、自分がどこに偏っているのかが一目で分る。STYLE COFFEE だけ27回で、ひとりだけ桁が違う。

都道府県の塗りつぶしもあって、色の付いていない県を眺めて次に買うお店を探すのに使っています。

地図は Leaflet と 国土地理院の淡色地図 で描いていて、データは Notion に付けていた記録と注文メールを付き合わせて JSON にしました。

富山、福井、鹿児島、沖縄で通販をやっている焙煎所を知っている人がいたら教えてください。

Agent Safehouseからnonoに移行した

以前の記事でClaude CodeをAgent Safehouseのsandboxに入れて使っていると書いたけど、nonoに乗り換えた。

きっかけはLinuxマシンでもClaude Codeを動かすようになったこと。Safehouseはsandbox-execをラップするやつなのでmacOS専用で、Linux側は素のままになっていた。nonoはmacOSではSeatbelt、LinuxではLandlockを使ってカーネルレベルでアクセスを制限してくれる。しかも設定は同じJSONのプロファイルで書ける。MacとLinuxで同じsandboxを1つの設定で管理できるのが決め手だった。

nono

nono.sh

MacはHomebrewで入る。

brew install nono

Linuxはインストールスクリプトが用意されている。Debian・Fedora・Archのパッケージもあるので、詳しくは公式のインストール手順を見てください。LandlockのためにLinuxカーネル5.13以降が必要です。

curl -fsSL https://nono.sh/install.sh | sh

あとはnono runでコマンドを包むだけ。

nono run --profile claude --allow-cwd -- claude

Safehouseとの一番の違いは、ポリシーをJSONのプロファイルで宣言的に書くところ。プロファイルはextendsで継承できて、registryで配布されているnolabs-ai/claudeを土台にできる。~/.claudeへの書き込み許可や~/.ssh・キーチェーン・シェル履歴の拒否といったClaude Code向けの基本設定が最初から入っている。中身はnono profile show nolabs-ai/claudeで確認できます。

自分のプロファイルはこれを継承して、手元で使うディレクトリやソケットを足していく。OSごとの差分はplatform_overridesに書く。

{
  "extends": "nolabs-ai/claude",
  "filesystem": {
    "allow": ["$HOME/.cache"],
    "read": ["$HOME/.config/git"]
  },
  "platform_overrides": {
    "linux": {
      "filesystem": { "allow": ["$HOME/local/src"] }
    },
    "macos": {
      "filesystem": {
        "allow": ["$HOME/Library/Developer/Xcode/DerivedData"],
        "unix_socket": ["$HOME/.gnupg/S.gpg-agent"]
      },
      "unsafe_macos_seatbelt_rules": [
        "(deny file-write* (subpath \"/Users/sixeight/.config/nono\"))"
      ]
    }
  }
}

(実際はこの何倍もあるので、雰囲気だけ)

allowが読み書き、readが読み取り専用で、Safehouseの--add-dirsと--add-dirs-roにそのまま対応する。型付きの設定で表現できないものはunsafe_macos_seatbelt_rulesに生のSBPLを書ける。Safehouseのときに.sbファイルで足していたルールはここに移した。

移行

Safehouse時代の設定は、168行のシェルスクリプトと.sbファイル9個の寄せ集めになっていた。これをnonoのプロファイル1枚と短いsafeラッパーに置き換えた。対応はだいたいこんな感じ。

Safehouse nono
--add-dirs / --add-dirs-ro filesystem.allow / filesystem.read
.sbで足したUnixソケットの許可 unix_socket / unix_socket_dir
.sbで足したそれ以外のルール unsafe_macos_seatbelt_rules
--enable=clipboard 何も書かずに通った
worktree用の--add-dirs safeから--allowで渡す

safeラッパーも書き直した。worktreeのためにメインリポの.gitへ書き込みを許可するのは前回と同じで、nonoでは--allowで渡す。

args=(run -s --profile claude --allow-cwd)

git_info="$(git rev-parse --show-toplevel --git-common-dir 2>/dev/null || true)"
if [[ "$git_info" == *$'\n'* ]]; then
  git_root="${git_info%%$'\n'*}"
  git_common_dir="${git_info##*$'\n'}"
  [[ -d "${git_root}-worktrees" ]] && args+=(--allow "${git_root}-worktrees")
  if [[ "$git_common_dir" != ".git" ]]; then
    args+=(--allow "$(dirname "$git_common_dir")")
  fi
fi

exec nono "${args[@]}" -- "$cmd" "$@"

Linux側はこれだけで動いた。Macはこれまで通すために積み上げてきた例外が多いぶん、いくつかハマった。

ハマったところ

HOMEでは起動できない。nonoは自分の状態を~/.local/state/nonoに置いていて、それを含むディレクトリ(HOMEや~/.local/state)は許可できない。HOMEでClaude Codeを起動することがたまにあるので、safeではHOMEのときだけ--workdir ~/.config/claudeでsandboxに入り、中でcd ~している。~/.local/stateもまるごとは許可できないので、gh・mise・pnpmなど必要なものだけ個別に許可した。

sandboxの入れ子ができない。SwiftPMやxcodebuild、Codexは自前でsandbox-execをかけようとする。けどnonoのSeatbeltの中ではネストできず、sandbox_apply: Operation not permittedで落ちる。それぞれのsandboxを外すshimを書いてPATHの先頭に置いた。外側のnonoの制限はそのまま効いているので問題ないと判断している。

case "${1:-}" in
  build | test | run | package)
    exec "$real_swift" "$1" --disable-sandbox "${@:2}"
    ;;
esac
exec "$real_swift" "$@"

gpg署名。nolabs-ai/claudeは~/.gnupgを拒否するグループを含んでいる。その中のロックファイルへの書き込みは型付きの設定(bypass_protectionとallow_file)では通らなかった。生のSBPLで書いたら通った。sandbox内のgpgはgpg-agentを起動できないので、safeで事前にgpgconf --launch gpg-agentしておく必要もある。

Unixソケット。tmuxやcolimaのdockerなど、ソケットにconnectするものはunix_socketで明示的に許可しないと繋がらない。

/tmpに書けない。書き込めるのは/tmp/claude-$UIDだけなので、Pythonのtempfileがカレントディレクトリにフォールバックしてリポジトリに一時ディレクトリを残していた。safeでTMPDIRをそこに向けて解決した。

拒否されたパスを調べるときはnono why --self --path <path> --op readをsandboxの中から叩くと理由を教えてくれるので便利。

あと、sandboxの中から自分のプロファイルを書き換えられると、次の起動で権限を広げられてしまう。なので~/.config/nonoへの書き込みは拒否している。Safehouseのときと同じで、プロファイルの変更はsandboxの外からやる。

MacとLinuxで同じsafe claudeが同じように動くようになって、めちゃくちゃ楽になった。

ソフトウェアの産業革命

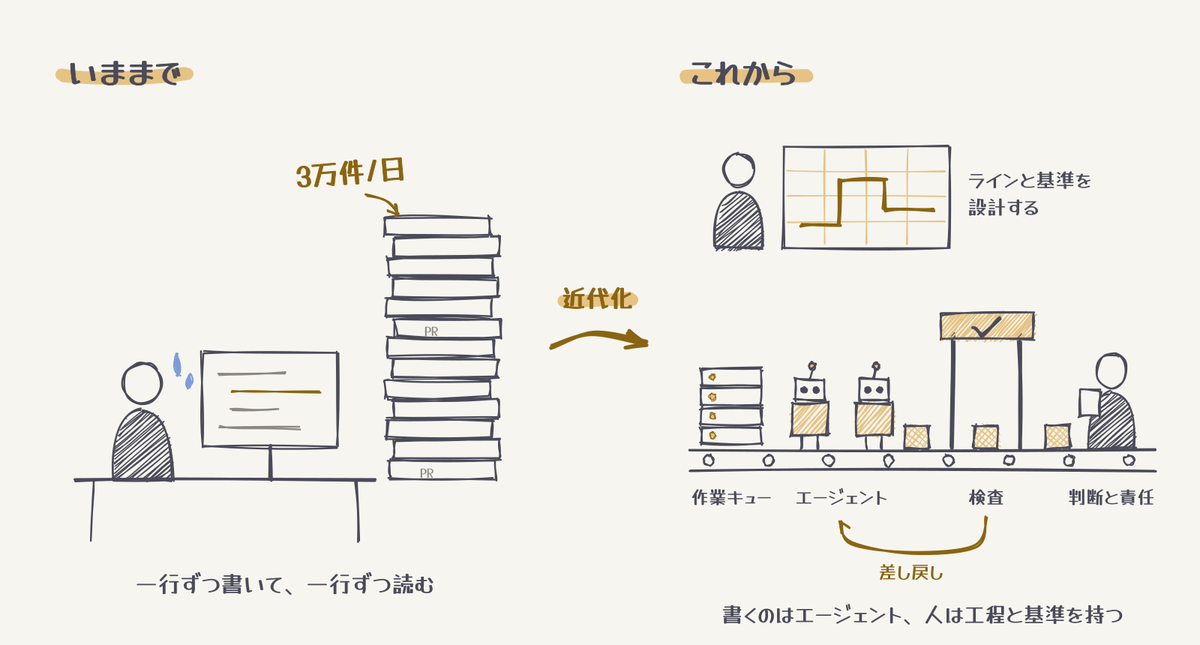
2026年9月、Anthropicの社内リポジトリには1日あたり3万件を超える変更がマージされていたそうです。5月の時点ではおよそ2,500件だったので、4か月で10倍以上。書いているのはほとんどがコーディングエージェントです。

この3万件を人が一行ずつ読んでいるとは思えないし、誰も読まずに本番へ出しているとも思えない。じゃあどうしているのか、というのが最近「ソフトウェアファクトリー」と呼ばれている話の出発点です。

名前だけ聞くとまたバズワードかという感じがするのだけれど、僕はこれを新しい開発手法の流行ではなく、これまで手作業でやってきたソフトウェア開発を近代化しないといけないという話だと受け取っています。ソフトウェアエンジニアの仕事はもう変わってしまった。

書く速さが読む速さを追い越した

各社が出している数字は、どれも同じ向きを向いています。

報告元 書く側 読む側
Meta 開発者1人あたりの月間 diff 数が前年比 +51%。増加分の8割超がエージェント由来 24時間以内にレビューされる diff の割合が低下
Imprint 平均的なエンジニアのマージ PR 数が2年前の4倍 レビュー所要時間の中央値が33分から77分へ
Anthropic エンジニア1人あたりのコミット数が半年前の5倍 対話型セッションの約80%でエージェントが人の入力を待っている

どれも自社報告で定義も揃っていないので横並びの比較はできません。それでも、書く側が速くなった分だけ待ち行列が読む側に移った、という点は共通しています。

読む人を増やせばいいかというと、エージェントを何本並べても、人が読める量は増えません。なので、読む量を減らしても壊れない仕組みを作るしかない。

工場という言葉が指しているもの

この語彙を整理したのがAddy Osmaniの「The Factory Model」(2026-02-25)です。記事の中心にあるのはこの一文です。

Coding has changed dramatically. Software engineering, at its core, has not.

コーディングのやり方は劇的に変わったけれど、要件、抽象化、テスト、トレードオフ、監督といったエンジニアリングの中身は変わっていない、という指摘です。

エージェントが数十分から数日かけて自律的に動くようになると、人は一つひとつの変更に付き添えなくなります。だから人の仕事は製品を作ることから、製品を作る工場を作ることへ移る、というのがOsmaniの主張です。

工場長は製品を一つずつ組み立てません。決めるのはラインの構成、検品の基準、不良が出たときにラインを止める条件です。ソフトウェアに置き換えると、エージェントに渡す作業キュー、エージェントが使う道具と情報、出来上がったものを検査する仕組み、検査に落ちたときの差し戻し経路になります。

Osmaniは参照実装として addyosmani/factory も公開しています。GitHubのIssueとラベルを作業キューにして、人が書く方針ファイルで危険の境界を決め、毎回同じ結果を返す検査スクリプトで合否を出し、実装役と検証役のエージェントを分ける。

成功した作業は下書きのPRで止まり、マージは人がします。レビュー待ちが溜まったら新しい実装を止める条件まである。

こう並べると、目新しい道具はひとつもありません。これまで手でやっていたことに、置き場所と名前を与えただけです。

同じリポジトリのADVICE.mdには、既製のコーディングエージェントに明確な作業単位とリポジトリ内の指示を足すだけで意外と遠くまで行ける、とも書いてあります。工場を足すのは無人で回したい、検証の範囲を区切りたい、といった必要が出てきてからでいい。工場とは導入するものではなく、工程と検査を設計し始めたときに付く名前なのだと思う。

明かりを消すか、残すか

Osmani自身、同じ記事でこう書いています。

Generation is not the bottleneck anymore. Verification is.

書く手段は揃ったけど、書かれたものが正しいと確かめる手段は揃っていない。

製造業には、人がいないので照明も要らない無人工場を「ライツアウト」と呼ぶ言い方があります。Dan ShapiroはAI支援の段階をLevel 0から5に分け、最上位をダークソフトウェア工場と呼びました。名前の由来は、ロボットが働くFanucの無人工場です。

It's dark, because it's a place where humans are neither needed nor welcome.

人間は必要とされず、歓迎もされない。だから暗い。

実際に明かりを消した会社もあります。StrongDMのCTO、Justin McCarthyの「Software Factories And The Agentic Moment」に掲げられた規則は二つだけです。

Code must not be written by humans

Code must not be reviewed by humans

コードは人間が書いてはならないし、人間がレビューしてはならない。

逆に、消してから戻した人もいます。HumanLayerのDex Horthyは2025年7月から明かりを消した運用を試し、数か月でエージェントが行き詰まったと講演で話しています。原因はモデルの強化学習の報酬がテスト合格に偏っていて、保守しにくいコードに罰がないことだそうです。対策は設計の前倒しと、コードレビューを戻すこと。

正反対に見えるのだけれど、二人が見ているものは同じだと思います。StrongDMも、人がコードを書かないやり方でどこまで行けたかをこう振り返っています。

Not very far! At least: not very far, until we added tests. However, the agent, obsessed with the immediate task, soon began to take shortcuts: return true is a great way to pass narrowly written tests, but probably won't generalize to the software you want.

テストを足すまではあまり進まず、足したら今度は、狭く書かれたテストを return true で通す近道を覚えられた。

リポジトリの中のテストはエージェントが書き換えて通せてしまう、という点で両者は一致していて、違うのは対策だけです。StrongDMはエージェントが触れない検査を外に作り、Horthyはコードレビューを戻しました。

Osmaniの「Software Factories, Light and Dark」(2026-07-20)は、その間に線を引いています。

Back pressure is the rule that you can only hand a loop as much autonomy as you can cheaply and reliably verify, and not one inch more.

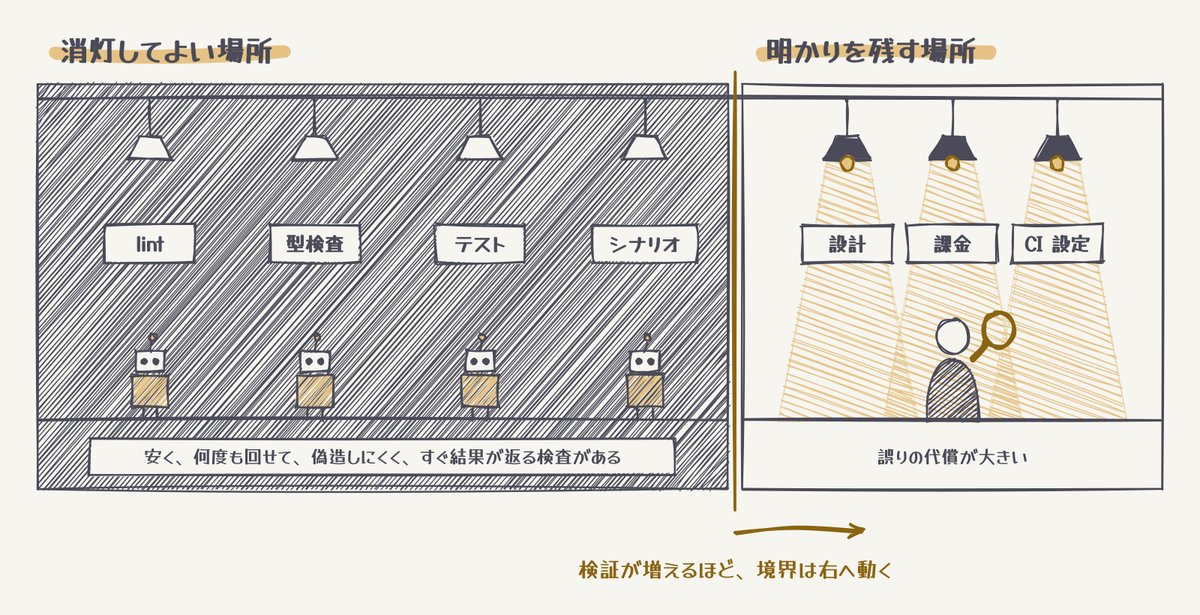
安く信頼できる形で検証できる分だけエージェントに自律を渡し、それ以上は渡さない。これをバックプレッシャーと呼んでいます。消灯してよいのは、検査が安くて何度も回せて、偽造しにくく、すぐ結果を返す場所だけ。誤りの代償が大きい場所には明かりを残す。

工場で言えば、検品の自動化が進んだ工程から無人にしていく。ごく普通の話です。

検査を工程に組み込む

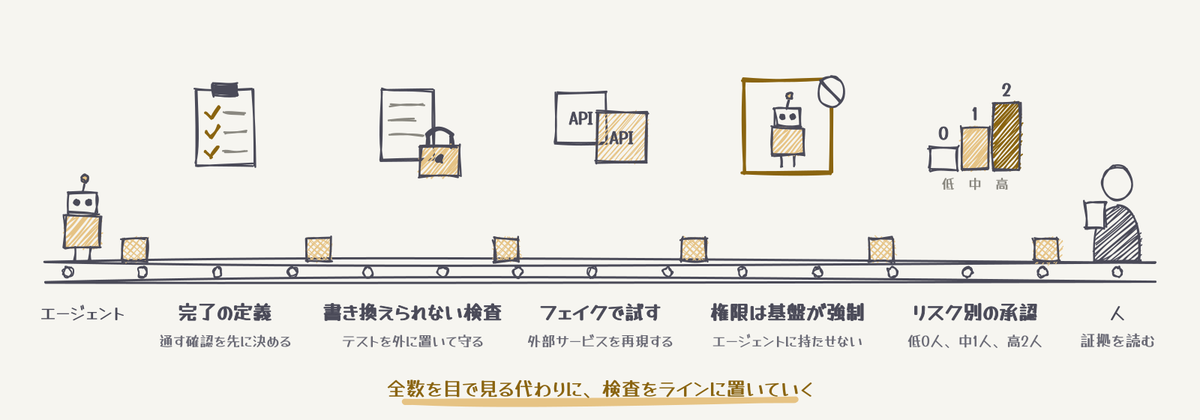
なので争点は「コードを読むべきか」ではなく「読まずに済む範囲をどこまで広げられるか」です。この秋に出てきた一次資料はその具体策で埋まり始めています。並べてみると、どれも人の目でやっていた検査を工程へ組み込む話です。

一番手前にあるのは完了の定義(Definition of Done)です。Osmaniは「Agentic Verification」で、コードより先に確認手段を書き、エージェントがそれを自分で回して通るまで繰り返す形を勧めています。

A human still owns what ships but now they're reviewing evidence and not just diffs.

出荷するものの責任は人が持ちつつ、見るのは差分だけでなく、スクリーンショットやトレースといった証拠になる。

次が、エージェントが書き換えられない検査です。StrongDMはテストの代わりに、利用者の操作を最初から最後まで書いたシナリオをコードベースの外に置き、エージェントがコードに合わせて書き換えられないようにしました。

StrongDMはさらに、Digital Twin Universeという環境を作りました。依存する外部サービス(Okta、Jira、Slack、Google Docsなど)のAPIとエッジケースまで再現した、精度の高いフェイクです。レート制限やAPIの費用を気にせず、1時間に数千のシナリオを回せるそうです。

Creating a high fidelity clone of a significant SaaS application was always possible, but never economically feasible.

高精度なSaaSの複製は昔から作れたけど割に合わなかった。エージェントのおかげで採算が合うようになった、というのがMcCarthyの説明です。

テストが全部通っても、エージェントが触れてはいけないものに触れていたら別の問題です。2026年4月に、コーディングエージェントが無関係なファイルにあったトークンを使って本番データベースとバックアップを9秒で削除した件がありました。参照アーキテクチャ「The Secure Software Factory」の原則はこうです。

the agent proposes, policy authorizes, and infrastructure enforces.

エージェントが提案し、ポリシーが認可し、インフラが強制する。タスクごとに使い捨てるサンドボックスと、既定で外部通信を拒否するネットワークで、そもそもトークンを使えない構造にします。

最後が、リスクに応じて人の承認を減らす仕組みです。冒頭のAnthropicの記事には、3万件の行方がこう書いてあります。

Our team members still review every change request for the system, but they now examine the intent of the change as opposed to reading every line of code.

すべての変更をレビューしているけれど、全行は読まず、変更の意図を見ている。

Claude Codeチームは変更内容を見る分類器でリスクを3段階に分け、低リスクは承認なし、中は1人、高は2人で、CIの設定のような機微な箇所は必ず人が見る。6〜9月にマージされたPRは2倍以上になり、revertされた割合は40%以上減ったそうです(自社報告)。

全数を職人が目で見ていたところから、自動検査と工程ごとの権限分離へ。製造業が通ってきた道を、ソフトウェアがいま通っているように見えます。

仕事は変わった

ではエンジニアの仕事はなくなるのかというと、そうではないと思います。Osmaniの記事の題がそのまま答えになっています。人の判断はソフトウェア工場から退場するのではなく再配置される(Human judgment doesn't leave the software factory. It relocates.)。

判断は上流に移ります。何を解くのか、どんな構造にするのか、品質の基準をどこに置くのか、検査の結果をどこまで信じるのか。Claude Codeチームはこれをもっと具体的に、そもそもそれを作るべきか、危険な箇所、後の実装が真似することになる設計、証拠を読むこと、結果への責任、と挙げています。最後の項目はこうです。

A person is accountable for every change that ships, whoever typed it.

NestJSの作者Kamil Mysliwiecも「Will We Write Code Again?」で近いことを書いています。これから重要になるのは書くことより、何を作り何を変えないか、何をもって完了とするかを記述することだ、と。自社のフレームワークと製品に利害がある立場で、データの裏付けもない主張ではあるのだけれど。手でコードを書く力より、工程と基準を設計する力が問われるようになった。

組織の側にも兆しが出ています。Anthropicの雇用に関する記事によれば、社内の面接評価で言及が一番増えたのは自律性と判断力で、専門知識への言及は減りました。技術職に占めるジュニアの比率は21%から14%へ、ジュニアの採用比率は27%から9%へ下がっています(ツールを使い始めた人にもともと偏りがあると本人たちも書いていて、ここから因果は読めません)。

もちろん、工場はまだ完成していません。ここに出てきた数字はほとんどが自社報告で、外部の検証を経ていません。Claude Codeチームでさえ、指標が悪化したときに承認を自動で厳しくするサーキットブレーカーはまだないと書いています。

理解の問題も残っています。和田卓人さんの講演「負債のメタファと2026年」のスライドは、技術的負債の比喩が生まれた1992年と2026年をこう並べていました。

人間達の理解が先行し、コードがついてきていない状態

AI によるコード生成が先行し、人間の理解がついてきていない状態

34年で、前を走るものと遅れるものが入れ替わった。

19世紀のイギリスでは、織物工業地帯の労働者や職人たちが機械を壊して回るラッダイト運動が起きました。彼らが怒っていたのは機械そのものより、低賃金や失業、熟練の価値が下がって暮らしが壊れることでした。ジュニアの数字を見ると、ソフトウェアでも似たような反発が起きてもおかしくない気がする。

それでも、力織機が止まらなかったように、この流れも止められないと思います。一行ずつ手で書いて一行ずつ目で読むやり方には、もう戻れない。

ただ、どの陣営も外していない条件がひとつあります。すべての変更について「なぜこれが存在するのか」を説明できる人がいること。その条件を保ったまま回り続ける工場を作るのが、これからの僕らの仕事なのだと思います。